La IA médica de Microsoft diagnostica mejor que los médicos: 83 % de aciertos en casos difíciles
 Carolina Méndez
4 min de lectura
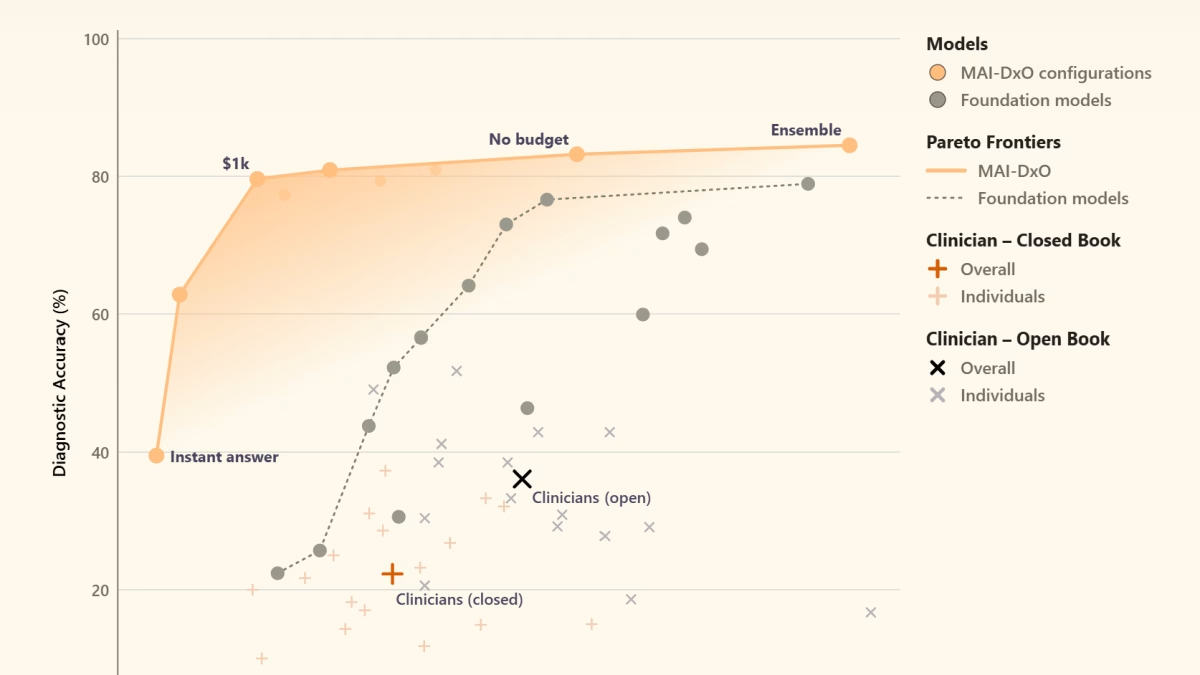
La IA médica de Microsoft acertó el 83 % de los diagnósticos más difíciles de la medicina en una prueba simulada, más del doble que los médicos generales. El estudio se publicó el 22 de octubre en la revista Science.
Microsoft no entrenó un modelo nuevo para lograrlo. MAI-DxO es una capa de orquestación que coordina varios agentes de IA como si fueran un panel de médicos: uno propone hipótesis, otro elige las pruebas útiles, otro contradice las conclusiones y otro vigila el coste, en rondas sucesivas de debate.

Cómo trabaja la IA médica de Microsoft
El sistema se evaluó con SDBench, un banco de 304 casos complejos publicados por The New England Journal of Medicine y cientos de ingresos de urgencias de la base de datos MIMIC-IV-ED. Cada caso empieza con información limitada: el sistema decide qué preguntar y qué prueba pedir, igual que haría un clínico de verdad, y ajusta su hipótesis a medida que llegan los resultados.
La orquestación funciona sobre modelos comerciales ya existentes. Microsoft la probó con GPT-5, GPT-5.5 y modelos de Google, Anthropic, Meta y DeepSeek. Los mejores resultados llegaron con GPT-5.5, y con GPT-5 por sí solo el sistema marcó 78,9 %, según reportó TechCrunch.
Los números exactos del estudio
La tabla resume lo publicado en Science y en el blog oficial de Microsoft:
| Prueba | MAI-DxO | Médicos generales |
|---|---|---|
| Casos complejos (NEJM) | 83 % | 36 % con referencias, 22 % sin ellas |
| Urgencias (MIMIC-IV-ED) | 80 % | 47 % |
| Coste por diagnóstico | 81 % de precisión a menos de la mitad del coste | — |
La ventaja en coste no es menor: la IA médica de Microsoft llega al diagnóstico correcto pidiendo menos pruebas y procedimientos, algo que en un hospital se traduce en tiempo y dinero. Microsoft señala que ningún otro enfoque humano o de IA logró a la vez más precisión y menos coste en ambas pruebas.
Lo que el 83 % no cuenta
El resultado es de laboratorio. Los casos eran simulaciones de expedientes ya documentados, no consultas con pacientes reales. Y la comparación se hizo contra médicos generales trabajando solos, sin especialistas ni equipos multidisciplinarios, que son quienes atienden estos casos en la vida real.
Los propios autores admiten que la brecha se reduciría frente a especialistas y que los casos del NEJM están seleccionados por su valor didáctico. La AAAS, la entidad que publica Science, advirtió además que los costes comparados son estimaciones y que el sistema no puede explorar físicamente a un paciente.
«Necesita validación clínica», reconoció Mustafa Suleyman, CEO de Microsoft AI, a The Verge. Sin esa prueba, el 83 % describe un entorno controlado, no la consulta del día a día.
La prueba que viene: pacientes reales en Boston
Microsoft anunció un estudio prospectivo con el Beth Israel Deaconess Medical Center de Boston. Los pacientes interactuarán directamente con el sistema y sus evaluaciones se compararán con las de médicos trabajando de forma independiente.
La compañía también abrió SDBench para que otros investigadores reproduzcan la evaluación y la desafíen, y reunió a sus equipos de salud —Microsoft Research, Dragon Copilot y PowerScribe— bajo Microsoft AI. En paralelo, publicó su visión de «superinteligencia médica» en BMJ Digital Health and AI y mantiene una colaboración con Mayo Clinic.
MAI-DxO demuestra que coordinar agentes de IA puede superar el razonamiento de un médico general aislado en casos difíciles, y por eso la IA médica de Microsoft ya se estudia como posible herramienta de apoyo donde faltan especialistas. La pregunta que queda no es si la IA diagnostica bien en un simulador, sino si ayuda de verdad cuando un paciente está al otro lado. La respuesta llegará del hospital de Boston.
Fuentes
Blog oficial de Microsoft: «Construir la superinteligencia médica con IA»
Qore: «Microsoft: MAI-DxO logra 83 % en casos complejos simulados»