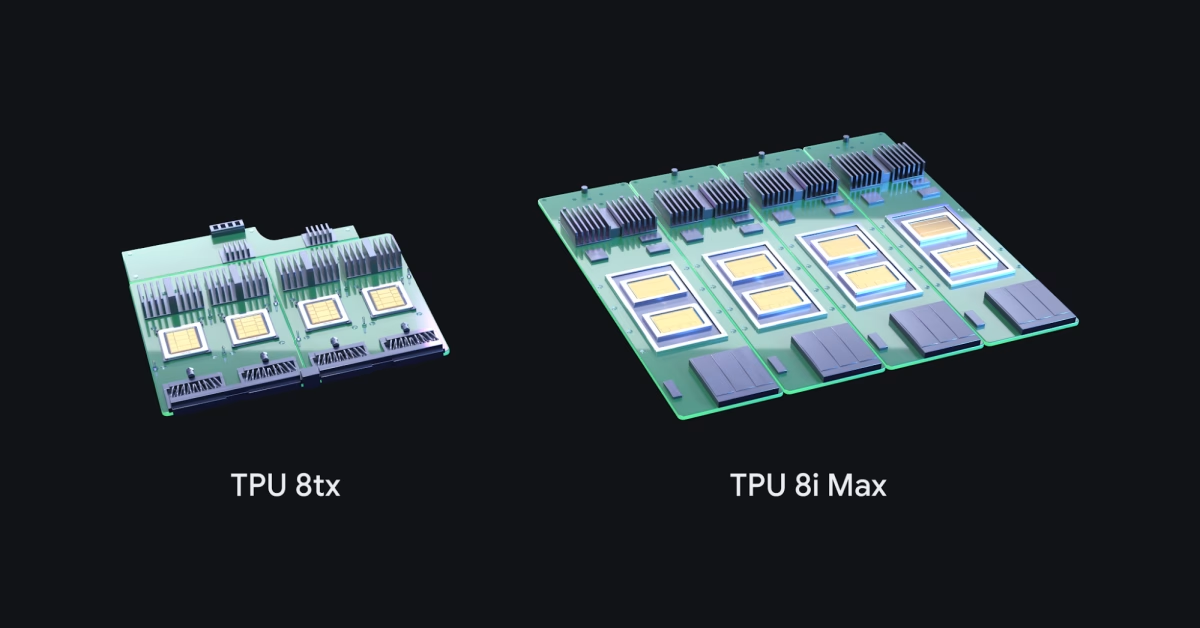
Google presentó este lunes 9 de noviembre las Google TPU 8tx y 8i Max, dos nuevos sistemas de inteligencia artificial para la era de los agentes autónomos: uno protege los datos mientras la IA los procesa y el otro duplica la memoria para contextos enormes.
El anuncio llega en un día movido para el sector. Mientras Nvidia atraviesa una tormenta interna por la investigación a su director ejecutivo, Google mueve ficha con hardware propio y su matriz Alphabet subió en bolsa.
Google TPU 8tx: la inteligencia artificial trabaja sin exponer tus datos
La primera novedad, la TPU 8tx, ataca un problema que hasta ahora parecía inevitable. Los datos suelen viajar cifrados y guardarse cifrados, pero en el momento en que el procesador los usa hay que descifrarlos. Esa ventana, aunque sea breve, es el punto débil que aprovecha cualquier ataque.
Google asegura que la 8tx cierra esa ventana directamente en el hardware: es el primer sistema TPU con computación confidencial impuesta por el chip, con los datos y los parámetros del modelo protegidos incluso durante la ejecución. Para lograrlo combina el silicio de la TPU 8t con procesadores AMD EPYC de quinta generación y una red de baja latencia llamada Boardfly.
El público al que apunta es claro: gobiernos, bancos y empresas de sectores regulados que quieren ejecutar sus propios modelos junto a sus datos más delicados, e incluso ajustarlos con información privada sin moverla entre servidores distintos.
En velocidad, la compañía promete hasta la mitad de latencia que la TPU 8t, con una penalización de rendimiento cercana a cero, según sus propias mediciones.
Google TPU 8i Max: memoria de sobra para agentes que piensan en grande
La segunda novedad, la TPU 8i Max, resuelve otro cuello de botella. Los agentes de inteligencia artificial ya no responden una sola pregunta: revisan repositorios completos de código, analizan documentos extensos, coordinan herramientas y trabajan durante horas. Para eso necesitan mantener muchísima información disponible al mismo tiempo.
La solución de Google fue directa: meter dos chips TPU 8i dentro de un mismo encapsulado. El resultado duplica el cómputo, duplica la memoria ultrarrápida del chip y duplica el ancho de banda de la memoria HBM frente a una TPU 8i individual. En cifras concretas, la 8i Max ofrece 384 GB de memoria HBM, un tercio más que los 288 GB de la 8i, y 768 MB de SRAM.
El objetivo es derribar lo que Google llama el «muro de la memoria»: cuando el modelo trabaja con ventanas de contexto de millones de tokens, lo que manda no es solo la potencia bruta, sino la rapidez con la que los datos llegan al procesador.
Google TPU 8tx y 8i Max: cuatro sistemas en un año
Lo más llamativo del anuncio no es un chip nuevo, sino la cadencia. Diseñar un semiconductor desde cero lleva años, pero remodelar el sistema que lo rodea —memoria, red, encapsulado— se puede hacer en meses. En abril Google presentó las TPU 8t y 8i, y con las Google TPU 8tx y 8i Max ya suma cuatro sistemas de octava generación en un mismo año.
La 8t quedó como la máquina de entrenamiento a gran escala, con superpods de hasta 9.600 chips y 121 ExaFlops, mientras la 8i se especializó en inferencia en tiempo real. Ahora la 8tx cubre la computación confidencial y la 8i Max las ventanas de contexto gigantes. El negocio ya cuenta con cerca de 100 clientes, entre laboratorios, universidades y empresas.
El lanzamiento no viene solo. Google también amplió el software que rodea a sus chips: TorchTPU, de código abierto, permite ejecutar código PyTorch de forma nativa en las TPU sin reescribirlo, y el motor Agent Compute Engine suspende las sesiones de agentes que quedan esperando una respuesta humana, para no tener los aceleradores ocupados sin hacer nada.
También llegó TPU Sync, una capa que coordina la memoria de los aceleradores, la del servidor y el almacenamiento como si fueran una sola jerarquía. Google afirma que recorta más del 90 % la latencia de transferencia de la memoria de trabajo y el tiempo hasta el primer token.
Lo que todavía no se sabe de las nuevas TPU
Hay tres datos que Google no dio y que importan mucho: no hay precios, no hay fecha de disponibilidad general y no hay regiones confirmadas para la 8tx ni para la 8i Max.
Tampoco hay una comparación independiente de rendimiento y costo frente a las GPU de su competidor. Todo apunta a que la partida se juega ahora en los sistemas completos, no solo en los chips: los acuerdos de IA en Corea del Sur muestran que nadie quiere depender de un solo proveedor.
Para las empresas reguladas, lo prudente es esperar a las pruebas independientes antes de firmar. Para el resto del sector, el mensaje es claro: con las Google TPU 8tx y 8i Max, Google ya no compite solo con un chip más rápido, sino con una familia completa de sistemas diseñados alrededor de lo que los agentes de IA necesitan para trabajar solos durante horas.
La carrera por la infraestructura de la inteligencia artificial entró en una fase nueva. Ya no gana quien entrena el modelo más grande, sino quien le da a los agentes la memoria, la seguridad y el software para sostener el trabajo de principio a fin.